Kitworks AI Connector · RAG і векторний пошук
Відповідь, зібрана з ваших документів, а не з інтернету
RAG знаходить у вашій базі знань саме ті фрагменти, що стосуються запитання,
і підставляє їх у запит до моделі. Пошук іде за змістом,
а не за точним збігом слів: питання «як повернути товар» знаходить
регламент повернення, навіть якщо в ньому написано «оформлення зворотної накладної».
Замовити демоПереглянути модуль на Apps Store
Пошук за змістом, а не за словами · 4 векторні бази на вибір · з локальним ембедингом
тексти не залишають вашу мережу
Як із сотень сторінок дістати ті два абзаци, що стосуються питання
Припустимо, регламенти й картки товарів уже в базі знань. Залишається питання, яке вирішує саме RAG: як із сотень сторінок дістати ті два абзаци, що стосуються запитання, і зробити так, щоб відповідь спиралася на них.
Пошук по ключових словах тут не рятує:
- Клієнт питає «чому не проходить оплата», а в інструкції це названо «відхиленням транзакції». Збігу слів немає, документ не знайдений.
- Пошук віддає двадцять сторінок, де слово трапляється хоч раз, і жодна з них не про суть питання.
Додається ще й технічне обмеження: весь ваш архів у запит до моделі не влізе, тож звужувати доводиться саме за змістом.
Як це працює — 3 кроки
Фрагменти стають векторами
Кожен фрагмент вашої бази знань проходить через ембединг-провайдера і перетворюється на числовий вектор, тобто координати змісту. Близькі за смислом тексти опиняються поруч у цьому просторі, навіть якщо написані різними словами. Вектори лягають у обране вами сховище.
Запит шукає найближче
Питання користувача теж стає вектором, і система шукає найближчі до нього фрагменти за косинусною близькістю. Ви задаєте, скільки фрагментів брати (типово 5) і наскільки близькими вони мають бути (типовий поріг — 0,7). Слабкі збіги відсікаються замість того, щоб розбавляти відповідь.
Знайдене підставляється у запит
Відібрані фрагменти складаються в блок контексту перед питанням користувача разом з інструкцією спиратися на них. Модель відповідає, маючи перед очима саме ваш текст. Формулювання цієї інструкції — окреме поле на картці агента.
Можливості
Семантичний і гібридний режими
Семантичний шукає за змістом. Гібридний додає до смислової близькості повнотекстовий пошук, і тоді точні терміни та артикули знаходяться надійніше. Вага ключових слів у підсумковому скорі налаштовується (типово 0,3). Гібридний режим доступний на бекенді pgvector.
Керовані параметри якості
Кількість фрагментів і поріг близькості винесені полями на картку агента, тож їх підбирають на живих запитах. Якщо відповіді занадто загальні, піднімають кількість фрагментів; якщо в контекст лізе зайве, піднімають поріг. Для кожного агента налаштування свої.
Ембединг-провайдер під вашу політику даних
OpenAI, Google або локальний Ollama. З Ollama тексти на векторизацію не виходять за межі вашої мережі. Провайдери перевикористовують уже налаштований конектор, окремий ключ заводити не треба.
Облік витрат на векторизацію
Кожен виклик ембедингу пишеться в журнал використання окремим типом. Для OpenAI кількість токенів береться з фактичної відповіді API, тобто це реальна цифра, а не оцінка.
Розмежування за компаніями й ролями
Джерела знань і векторні сховища мають правила доступу: рядовий користувач бачить дані своєї компанії, менеджер ШІ — усі. На рівні прав користувач має доступ на читання, змінювати конфігурацію може менеджер.
Чотири векторні сховища під різний масштаб
pgvector, FAISS, ChromaDB і Qdrant — від бази, що вже стоїть у вас, до окремого сервісу під великі обсяги. Порівняння — у наступному розділі.
Векторні сховища та типові параметри
Технічна частина, зібрана в одному місці: де лежать вектори і які значення стоять за замовчуванням.
Чотири векторні сховища під різний масштаб
pgvector | Живе прямо у вашому PostgreSQL, підтримує індекси HNSW та IVFFlat і єдиний дає гібридний пошук. |
FAISS | Тримає індекс файлами на диску. |
ChromaDB | Окремий сервіс для великих обсягів. |
Qdrant | Окремий сервіс для великих обсягів; фільтрує за джерелом на своєму боці. |
Типові значення параметрів
5
Фрагментів у контексті
Скільки знайдених фрагментів підставляється у запит. Поле на картці агента.
0,7
Поріг близькості
Наскільки близькими мають бути фрагменти. Слабкі збіги відсікаються.
0,3
Вага ключових слів
Внесок повнотекстової частини в підсумковий скор гібридного режиму.
Сценарії використання
eCommerce — консультація по асортименту й умовах
Клієнт формулює питання своїми словами: «чи є щось тепліше на зиму для дитини». Пошук дістає картки товарів і умови доставки за змістом. Для запитів з артикулами вмикається гібридний режим, де точний збіг критичний.
Виробництво — технічна документація й регламенти
Інженер питає про допуск або процедуру, і пошук знаходить потрібний абзац у сотнях сторінок. Поріг близькості ставлять жорсткіше, щоб у відповідь не потрапляли дотичні розділи.
Інтегратор / мультикомпанія
Розмежування джерел і сховищ за компаніями дозволяє тримати бази знань різних клієнтів на одній інсталяції. Бекенд обирається під масштаб кожного: комусь достатньо pgvector у наявному PostgreSQL, комусь ставиться Qdrant.
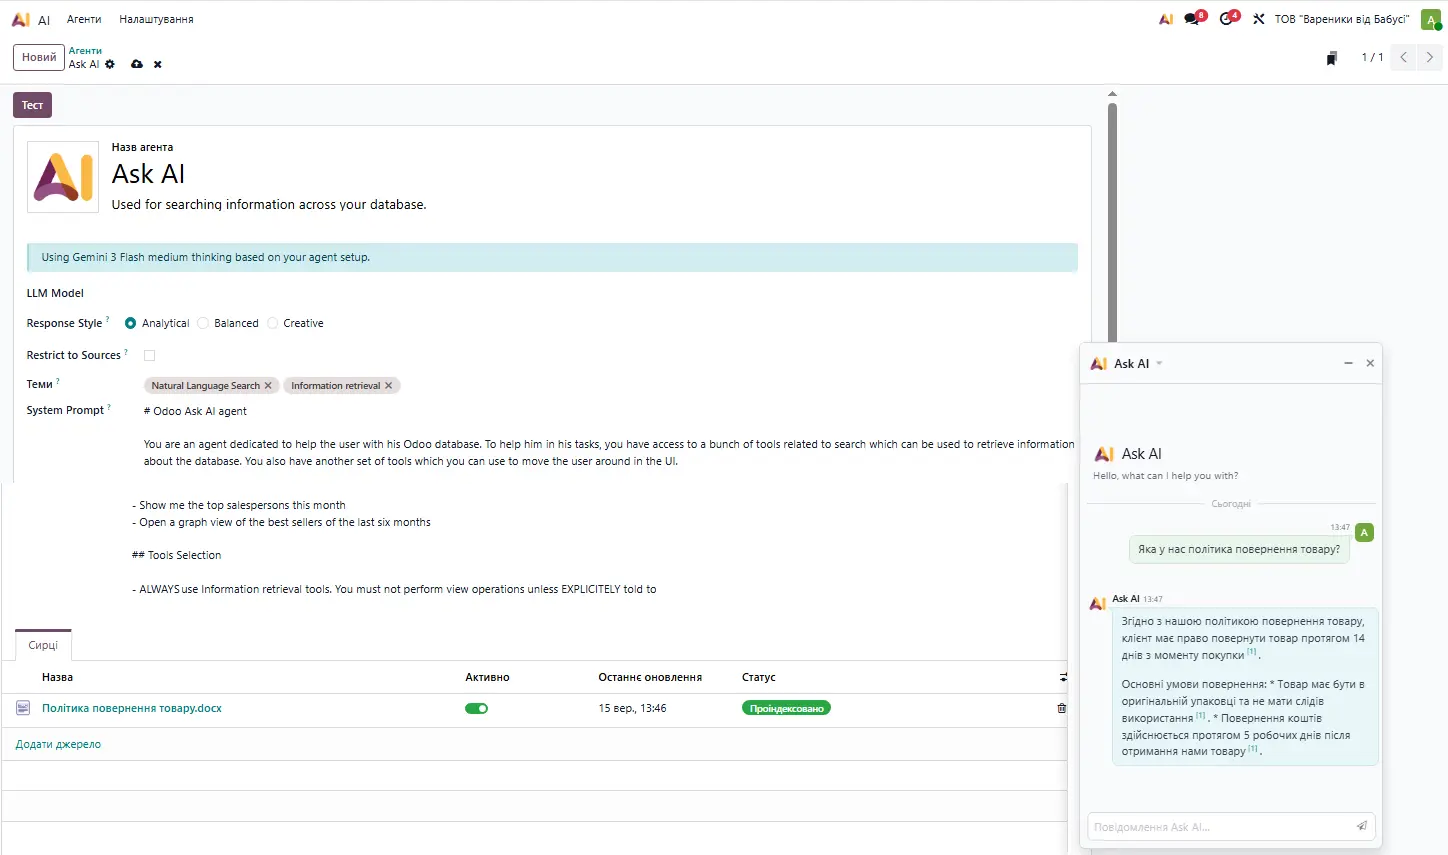
Як це виглядає в Odoo
Вкладка RAG на картці агента — поруч із чатом, де відповідь спирається на підставлений фрагмент.
Прив'язані джерела знань, поле кількості фрагментів, поріг близькості й вибір режиму — семантичний чи гібридний — усе в одній вкладці.
Часті запитання
Фільтр шукає за значеннями полів і потребує точного критерію, про це окрема сторінка /ai/search. RAG шукає за змістом тексту: питання й документ можуть не мати жодного спільного слова, але описувати одне й те саме, і фрагмент буде знайдений.
Сховища pgvector і FAISS не потребують зовнішніх сервісів: вектори лежать у вашому PostgreSQL або файлами на диску. З локальним ембедингом Ollama тексти на векторизацію теж не залишають мережу. З хмарними ембединг-провайдерами назовні йде текст фрагментів, і це варто врахувати при виборі.
pgvector підходить більшості: нічого додаткового ставити не треба, і тільки він дає гібридний пошук. FAISS — для простих локальних інсталяцій. ChromaDB і Qdrant — коли обсяг переріс базу. Бекенд змінюється без переписування логіки агента, під ваш випадок підкажемо на демо.
Спрацьовує поріг близькості: фрагменти, які до нього не дотягують, у контекст не потрапляють. Якщо не пройшов жоден, агент відповідає без підставленого контексту. Саме поріг захищає від ситуації, коли у відповідь підмішується випадковий дотичний абзац.
Так. Це прапорець на картці агента, типово вимкнений, і до нього список джерел, які саме цей агент має право використовувати.
Подивіться, що знайде пошук саме у ваших документах
На демо візьмемо ваш реальний документ і ваші типові запитання:
покажемо, що дістає пошук, як змінюється відповідь від
порогу близькості, і який бекенд відповідає вашому обсягу даних.
Читайте також
- Огляд Kitworks AI Connector → — хаб усіх ШІ-рішень
- База знань → — які документи й записи Odoo підключені та як ними керувати
- Пам'ять агента → — що він пам'ятає про попередні розмови
- ШІ-агенти → — на яких вмикається RAG
- Природномовний пошук по записах Odoo → — фільтр за полями, не семантика
- Демо → — форма запиту демонстрації
- Odoo Apps Store → — сторінки модулів RAG і векторних бекендів або AI-bundle